Kubernetes 为什么能自动化运维?
最近在学极客时间《Kubernetes入门实战课》,把第 10 讲工作机制这一块过了一遍。这篇文章是我学完之后的一些总结,主要想把自己理解的架构、组件和协作方式写清楚,后面排障时也有一条能顺着走的线。
容器解决的是“应用怎么打包、怎么分发”,真正难的是后面那一堆运维问题:调度到哪台机器、挂了怎么恢复、网络怎么通、状态怎么盯。Kubernetes 能成为事实标准,我觉得不只是因为它出身 Google,而是它把这些事抽象成了一套能自己运转的工作机制。
1. 先换一个视角:它更像集群操作系统
以前我习惯把 Kubernetes 当成“管容器的平台”。这当然没错,但还不够准。
容器本质是进程,服务器本质是 CPU、内存、磁盘、网卡。既能管软件,又能管硬件,这种东西在单机世界里就是操作系统。Kubernetes 做的事情很像,只不过它管的不是一台机器,而是几百几千台机器,以及跑在上面的大量进程。
所以我现在更愿意把它理解成集群级别的操作系统:核心能力就是资源管理和作业调度。
还有一个很实在的变化:Linux 面前通常是 Dev 和 Ops 两拨人,到了 Kubernetes 这里,开发和运维的边界会变模糊。开发从一开始就要想部署和运行,运维也得更早介入应用本身。对我来说,这意味着不能只把 YAML 丢出去就结束,得同时理解应用怎么跑、集群怎么管。
2. 基本架构:控制面指挥,数据面干活
Kubernetes 用的是现在很常见的控制面 / 数据面架构。
集群里的机器叫 Node,可以是物理机,也可以是虚拟机:
- Master(控制面):数量少,负责管理、调度、决策,相当于大脑和心脏。
- Worker / Node(数据面):数量多,真正跑业务,相当于手和脚。
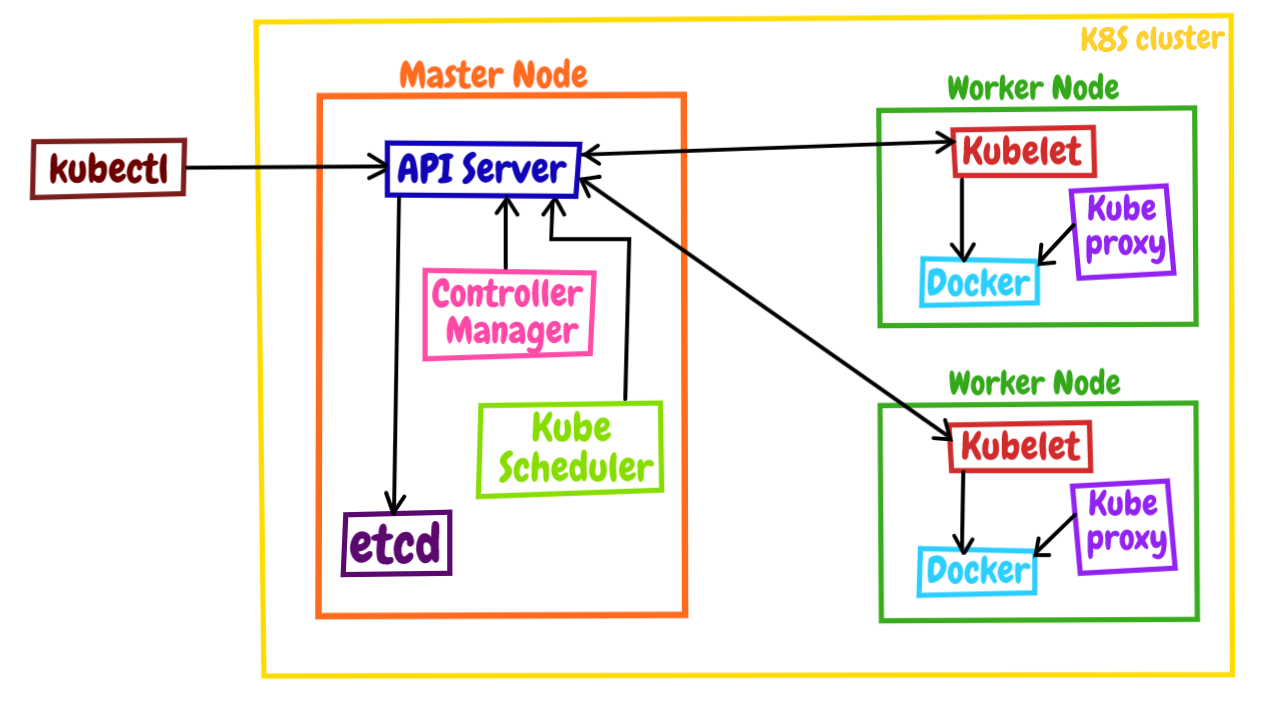
Worker 多了之后,资源会被“池化”。应用不是绑死在某台机器上,而是由集群在资源池里分配。所以加节点、删节点会比传统一台台手工维护轻松很多。
还有一个容易忽略的点:kubectl 看起来像集群的一部分,其实它在集群外面,只是客户端。我们所有操作,本质上都是在跟控制面说话。
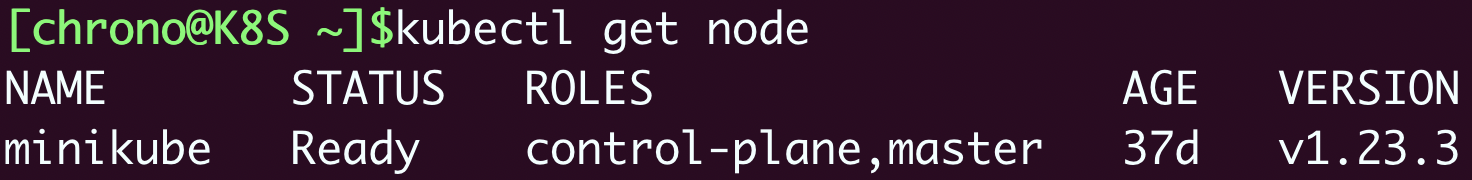
Master 和 Node 的划分也不是绝对的。集群很小的时候,Master 可以同时干活。minikube 就是这样:看起来只有一个节点,它既是 Master,也是 Node。
3. Master:四个组件,一个入口
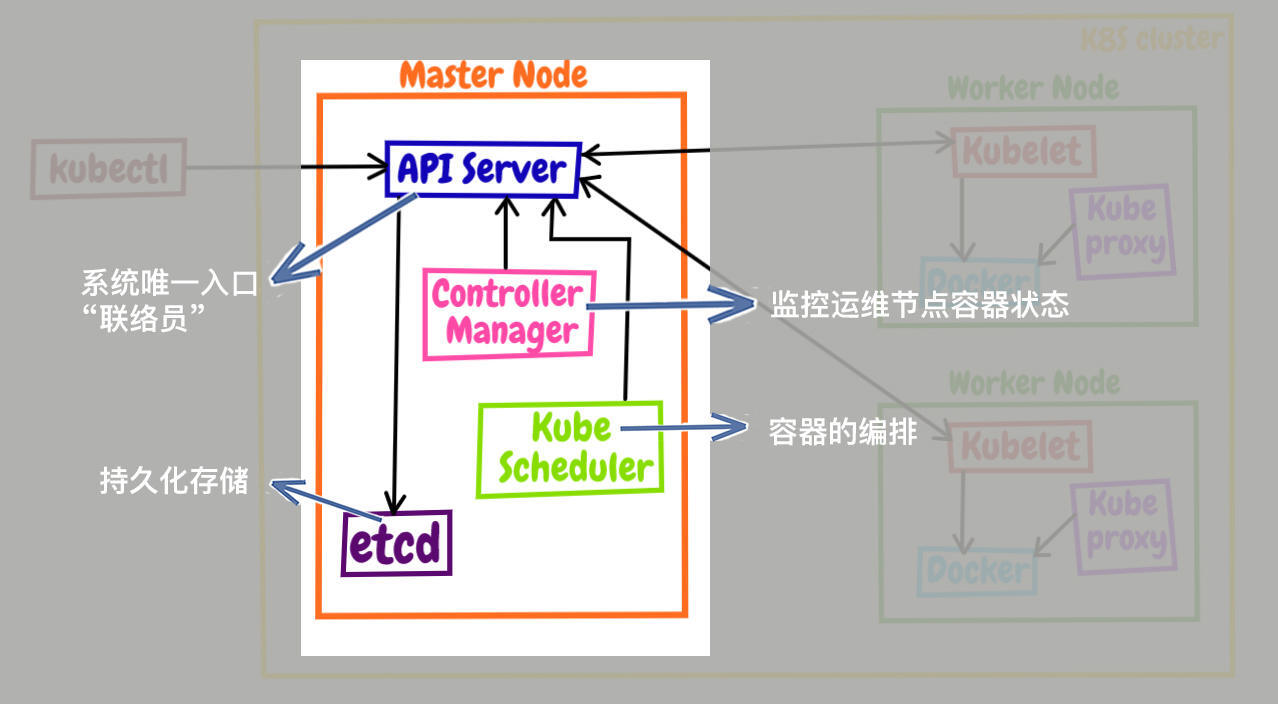
Master 里最核心的是四个组件:apiserver、etcd、scheduler、controller-manager。
我给自己的记忆方式是,把它们想成一个运维团队里的四个角色:
- apiserver:整个系统的唯一入口,对外提供 RESTful API,还负责认证授权。其他组件都不能直接互相乱通信,必须经过它。它就是联络员。
- etcd:高可用的分布式 KV 数据库,负责持久化集群对象和状态。它只和 apiserver 直接打交道,其他组件想读写数据,都得绕这一圈。
- scheduler:负责编排,看节点资源,把 Pod 放到最合适的节点上。它不负责把容器真正跑起来,只负责“这个任务去哪”。
- controller-manager:负责盯状态,做故障检测、服务迁移、扩缩容。目标很明确:让当前状态尽量靠近我们声明的期望状态。
这四个组件本身也经常以容器形式跑在 kube-system 里。用 kubectl get pod -n kube-system 就能看到 etcd、kube-apiserver、kube-controller-manager、kube-scheduler。
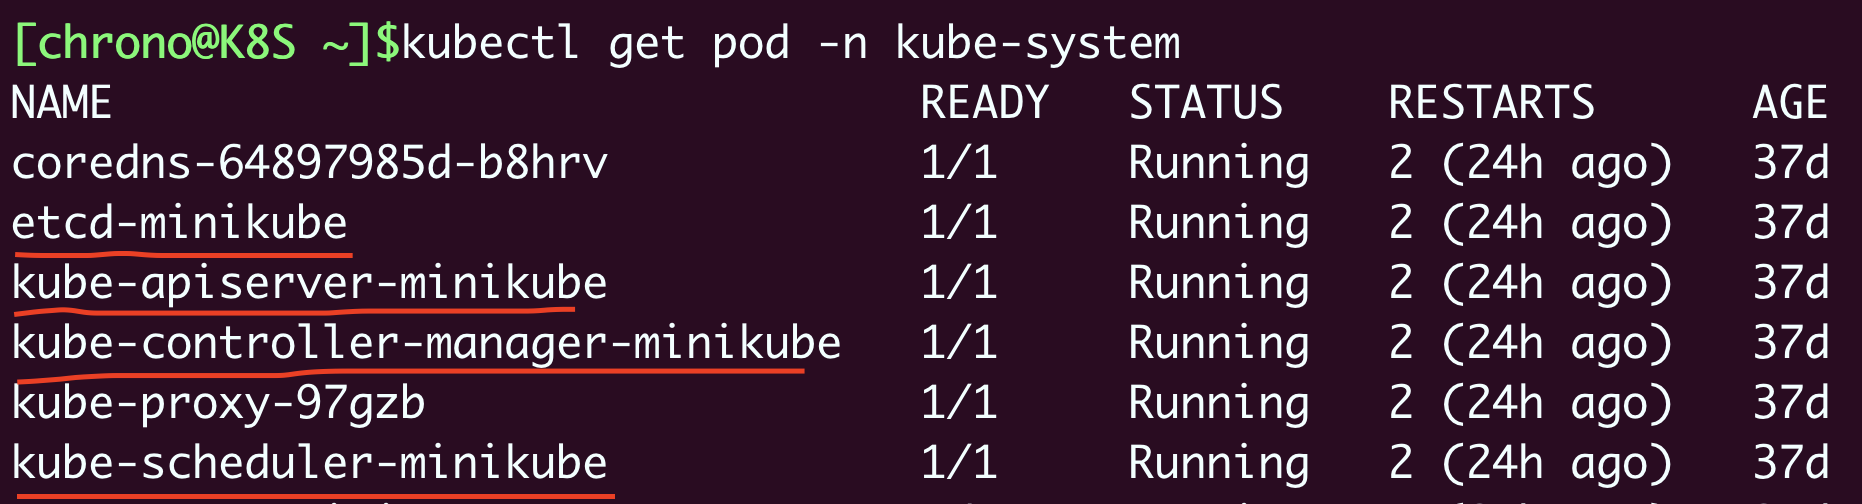
这里有个很关键的设计:etcd 不对外开放,大家只认 apiserver。我觉得这是 Kubernetes 能管得住复杂性的原因之一——入口收敛了,权限、版本、对象模型才好统一。
4. Node:真正把容器跑起来的地方
Master 再聪明,也得靠 Node 上报状态、执行命令。Node 上主要是三个组件:kubelet、kube-proxy、container-runtime。
- kubelet:节点上的小管家。Node 上只有它能直接和 apiserver 通信,负责上报状态、接收命令、启停容器。
- kube-proxy:专职管网络,给 Pod 转发 TCP/UDP 流量,让服务对外看起来更稳定。
- container-runtime:真正创建容器、管理 Pod 生命周期的人。可以是 Docker,也可以是 containerd、CRI-O,Kubernetes 并不绑定某一种实现。
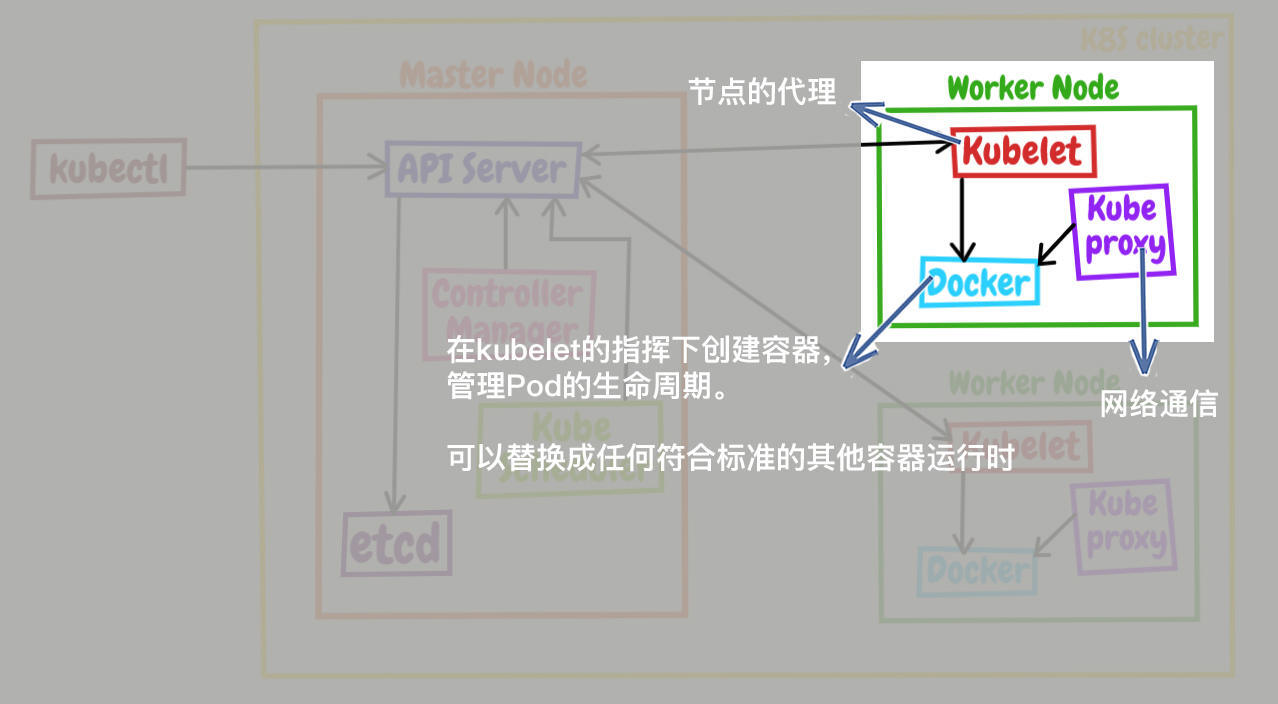
这三个里,kube-proxy 通常是容器化的;kubelet 不行。因为它要管整个节点,能力被容器限制住就不合适,所以它会作为宿主机进程跑着。这也解释了为什么 docker ps 能看到 kube-proxy,却看不到 kubelet,得用 ps 去查。


5. 它们是怎么自动转起来的
把 Master 和 Node 放到一起,工作流其实很清楚:
1 | kubelet 定期向 apiserver 上报节点状态 |
与此同时,kube-proxy 在每个节点上做转发,让容器对外提供相对稳定的网络入口。
以前这些事情也得做,只是靠人:看监控、改脚本、一台台登录、出了问题再半夜处理。Kubernetes 的高明之处,是把这套流程抽象成了规范组件。它们像一群不会累的运维工程师,一直在观察变化、互相协作、把集群往健康状态拉回去。
所以“自动化运维”不是口号,而是控制器循环:拿期望状态、看当前状态、算差异、做变更。只要这个环不断,集群就能自己收敛。
6. 插件:从“能跑”到“好用”
只要核心组件在,集群就已经能工作了。但“能用”和“好用”还差一层,这一层就是插件(Addon)。
插件不影响 Kubernetes 启动,却能明显增强能力。我觉得最重要的两个是:
- DNS:让服务用域名而不是 IP 通信,是服务发现和负载均衡的基础。
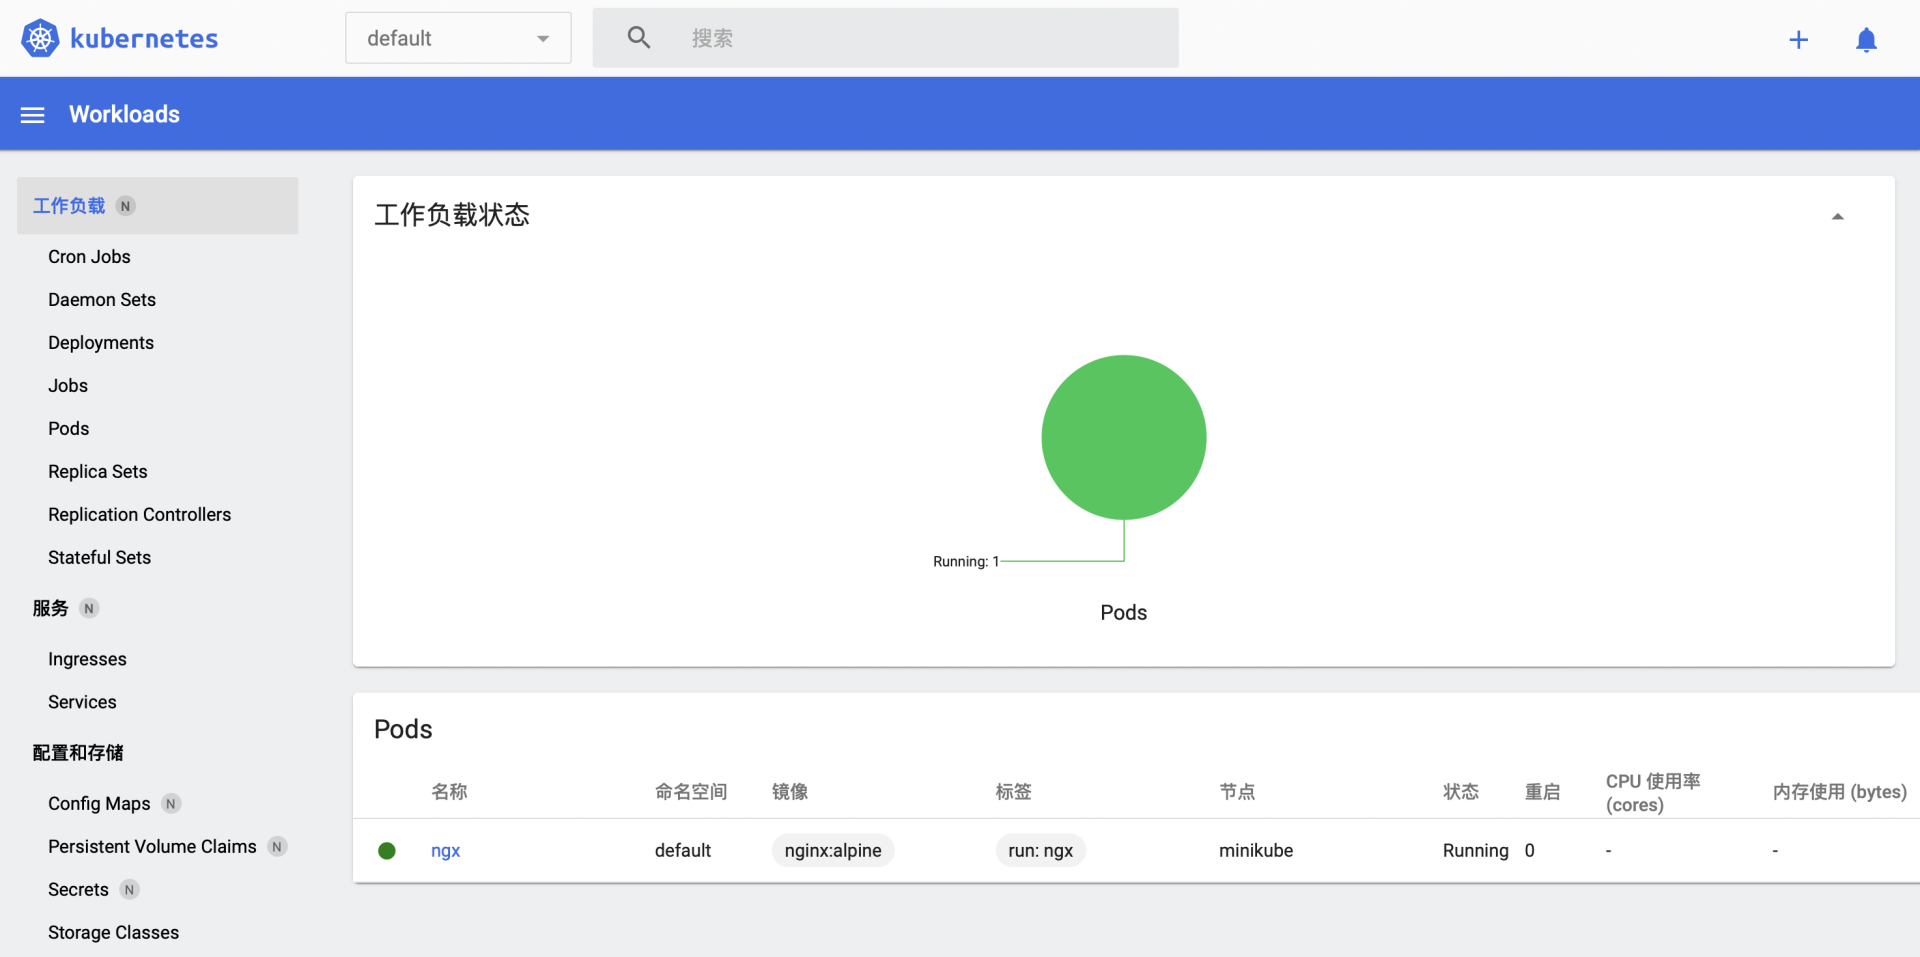
- Dashboard:图形界面,日常还是
kubectl更常见,但查状态、看工作负载时确实方便。
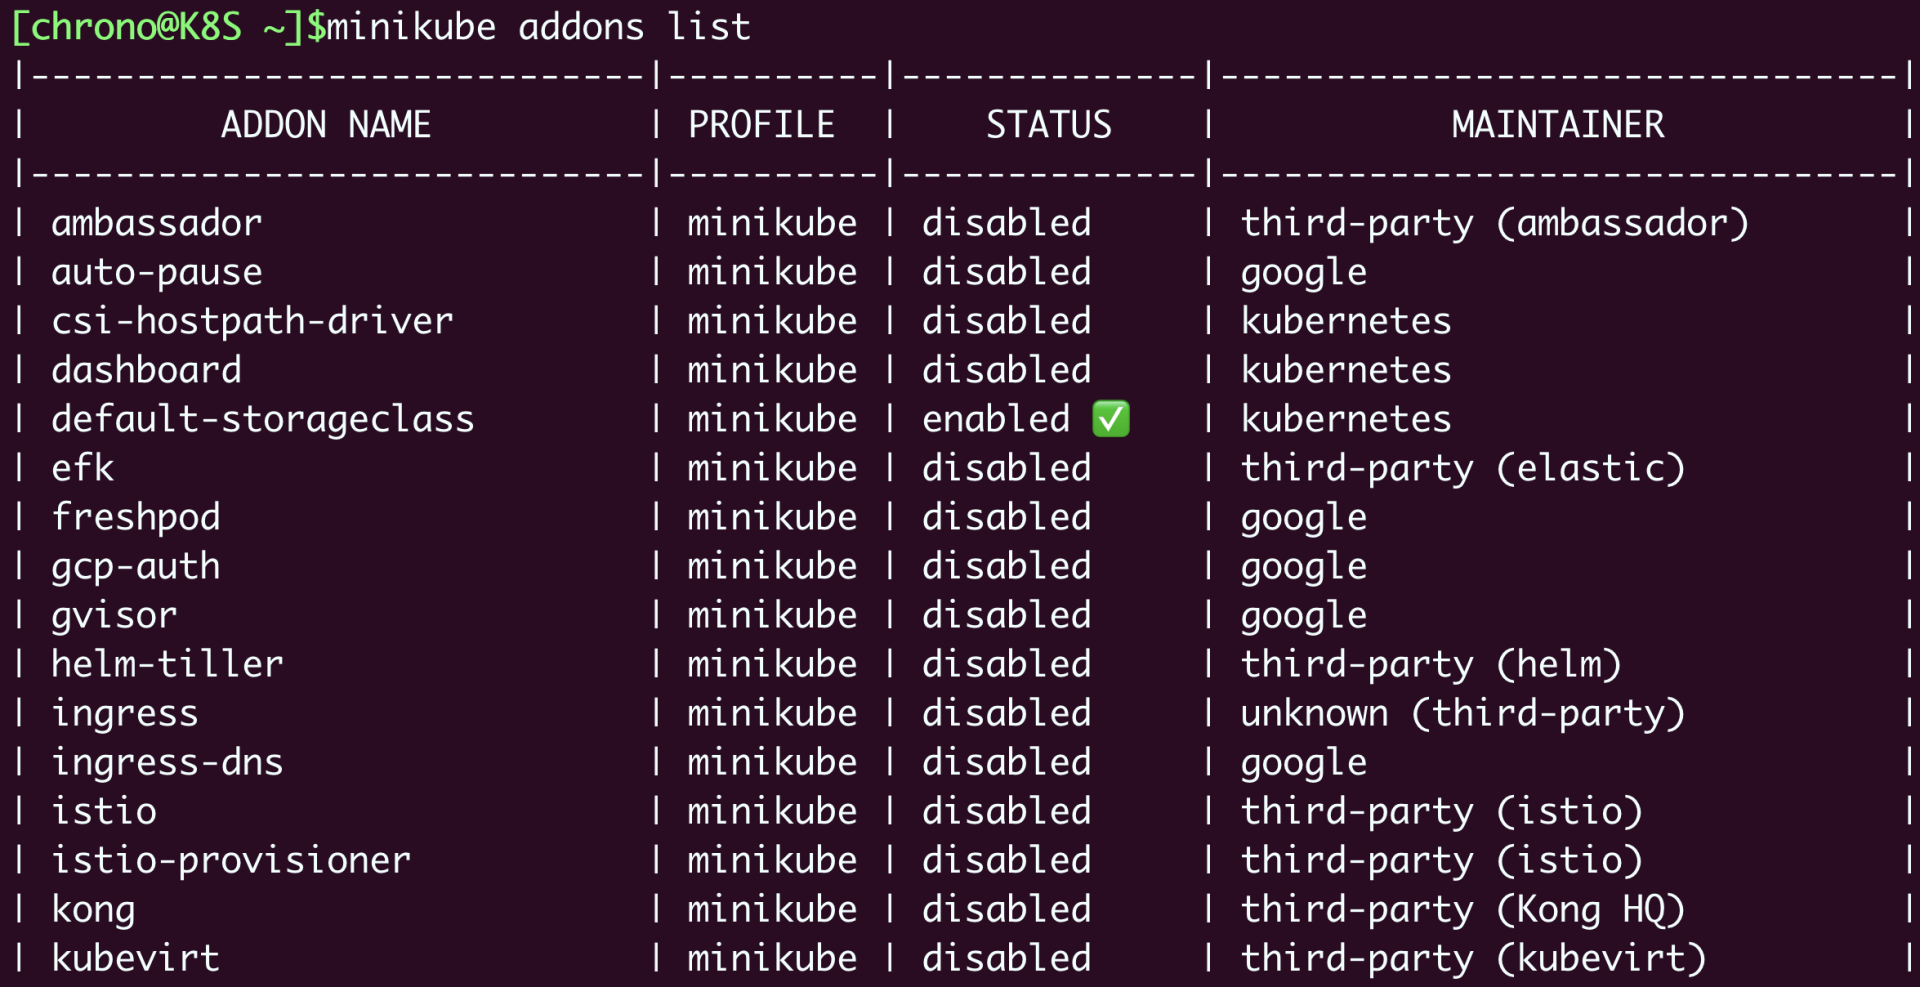
minikube 里可以用 minikube addons list 看有哪些插件,也可以用 minikube dashboard 打开仪表盘。需要注意,默认 Dashboard 通常只适合本机浏览器访问。
一张图把关系记住
原文最后有一张架构思维导图,我对完之后觉得比单纯背组件名好用得多:
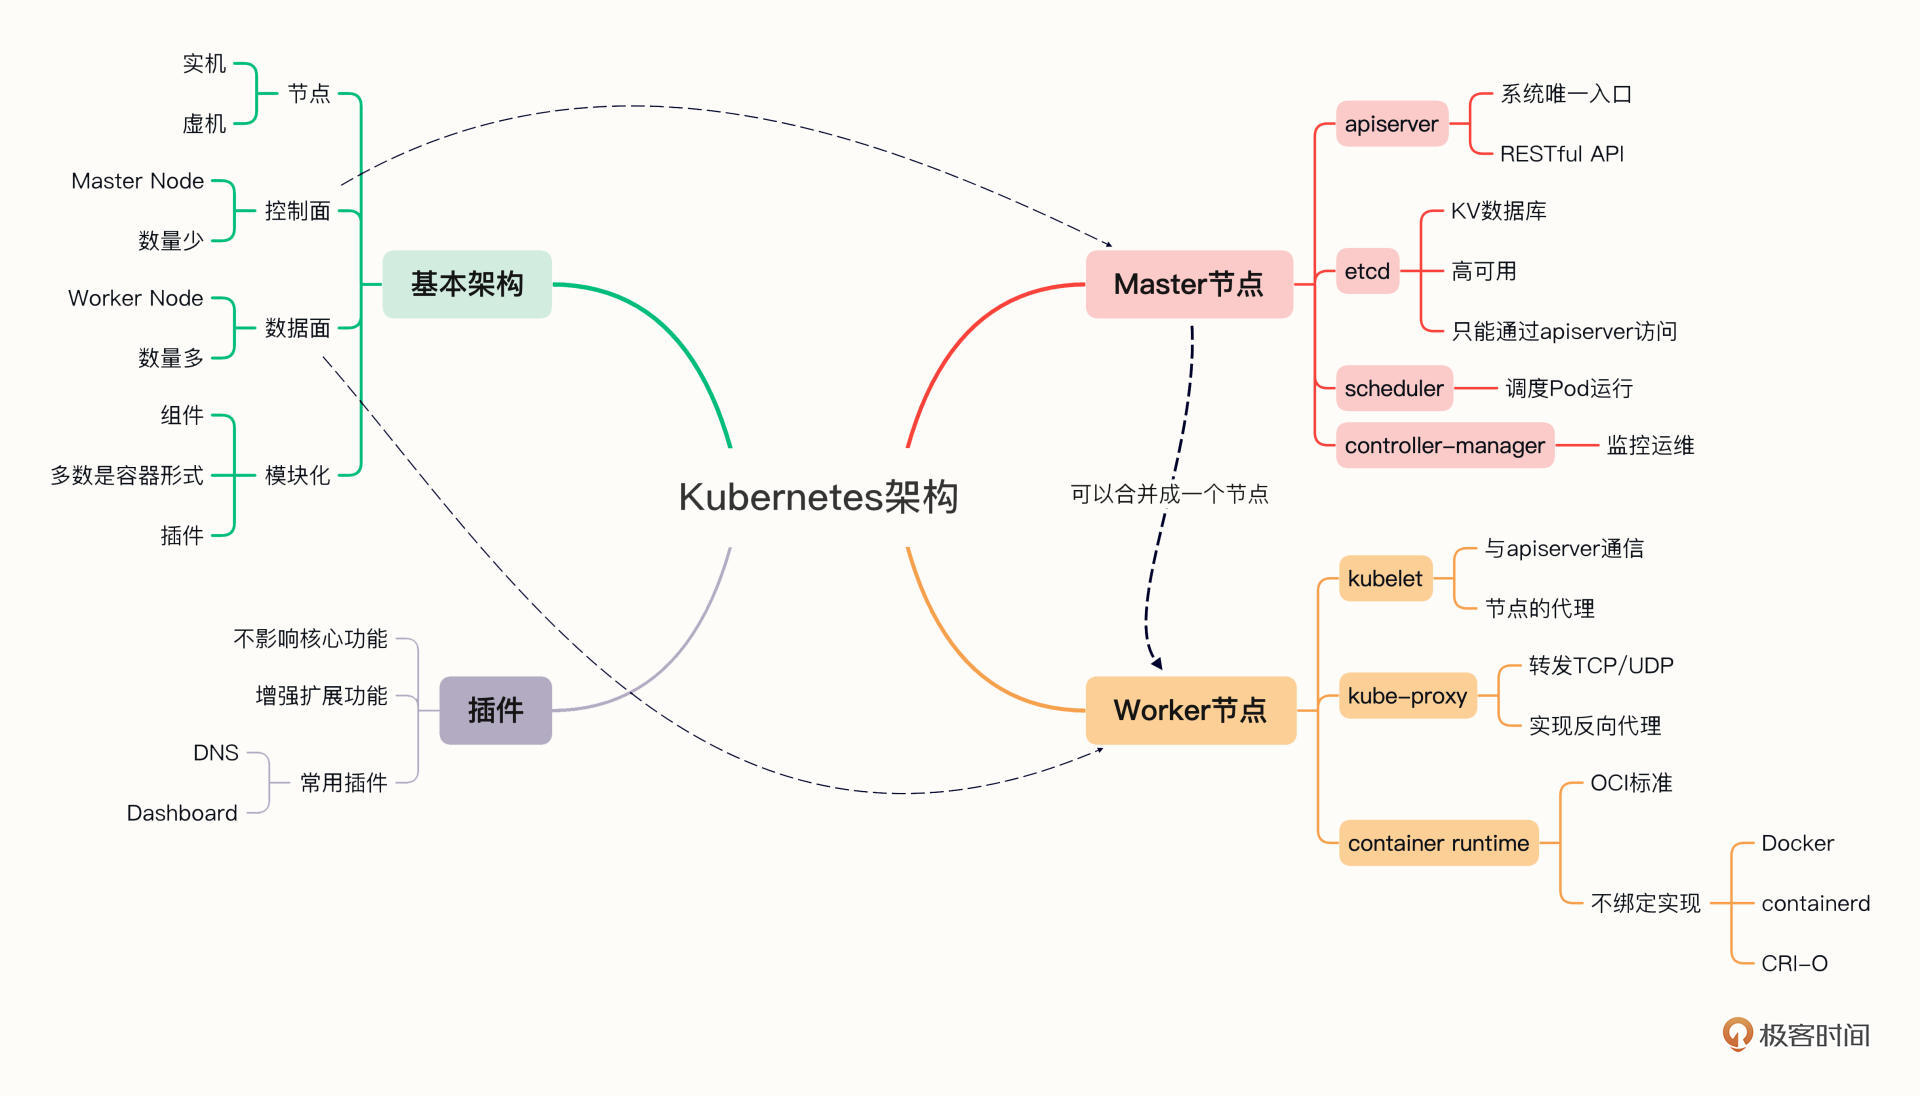
再压缩成一张表,方便自己往后查:
| 位置 | 组件 | 我理解的角色 | 一句话 |
|---|---|---|---|
| 集群外 | kubectl | 客户端 | 人操作集群的入口 |
| Master | apiserver | 联络员 | 唯一入口,所有通信都经过它 |
| Master | etcd | 账本 | 存对象和状态,只对 apiserver 开 |
| Master | scheduler | 调度员 | 决定 Pod 去哪台机器 |
| Master | controller-manager | 值班运维 | 让现状逼近声明的期望 |
| Node | kubelet | 节点代理 | 上报状态,执行命令 |
| Node | kube-proxy | 网络转发 | 让服务流量能稳定到达 Pod |
| Node | container-runtime | 真正干活的运行时 | 创建和管理容器 |
| 插件 | DNS / Dashboard | 增强能力 | 从可用变成更好用 |
没有哪个是多余的。没有 etcd,状态留不住;没有 apiserver,集群失联;没有 kubelet,节点接不住任务;没有 runtime,容器跑不起来;没有 controller,异常就得靠人盯。
几点思考与理解
第一,Kubernetes 算不算操作系统,我觉得“算,但不完全一样”。它确实在做资源抽象和调度,让我们少关心某台机器、某个端口、某个进程怎么手工安置。但它通常不直接管硬件,中间还隔着节点上的 Linux。更准确的说法可能是:它是云原生时代的集群操作系统,管的是池化之后的计算、网络和存储。
第二,最重要的组件不是某一个名字,而是那条通信约束:所有状态进出都经过 apiserver,etcd 是唯一账本,kubelet 是节点上唯一对控制面负责的人。 抓住这条线,后面看调度、扩缩容、自愈,都不会散。
第三,Master 高可用会自然碰到 etcd。控制面要稳,通常会有多个 Master,数量常见是 3、5、7 这种奇数,这和 etcd 用 Raft 保一致性有关。controller-manager 看起来是一个进程,其实是一堆控制器打包在一起,比如 Node Controller、Replica Controller,目的是少跑很多独立进程。
第四,学架构时别只背组件名。真正要建立的感觉是:我声明想要什么,集群自己去逼近。YAML 不是说明书附件,而是期望状态。这一点和传统“先写步骤,再按步骤执行”很不一样。
结语
Kubernetes 能自动化运维,靠的不是某一个特别聪明的脚本,而是一套分层清楚的机制:控制面做决策,数据面做执行,apiserver 做唯一入口,etcd 记住状态,控制器不断把现实拉回声明。
对我来说,这次学完最有用的不是又多记了几个名词,而是换了一种看集群的方式。以后再遇到调度失败、节点 NotReady、服务不通,我会先问:是状态没上报,是调度没选到节点,是 kubelet 没执行,还是控制器没把差异修回来?
把这条工作链路想清楚,Kubernetes 就不再只是一堆 YAML,而变成一个能自己运转的系统。
图片来源:极客时间 《Kubernetes入门实战课》 第 10 讲《自动化的运维管理:探究Kubernetes工作机制的奥秘》,作者 Chrono。